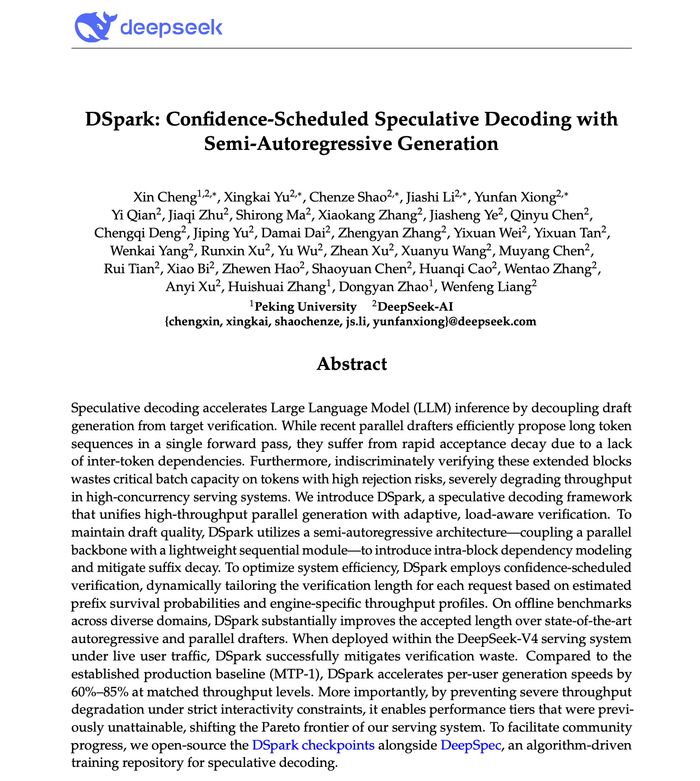
在当前人工智能领域,大型语言模型的推理效率成为业界关注的焦点。6月27日,DeepSeek在Github上发布了名为DSpark的最新论文,旨在解决大语言模型在高并发使用场景中的推理效率问题。
这篇论文由DeepSeek与北京大学联合撰写,DeepSeek创始人梁文锋也参与其中。论文开源了DSpark模型的权重,并同时发布了与推测解码相关的训练代码仓库DeepSpec。
论文标题虽显晦涩,但其内容展示了DeepSeek一贯的技术追求。在论文中,团队探讨了大语言模型使用自回归文本生成方式所面临的挑战。具体而言,每个新词元的生成过程需要依赖于所有前置词元进行完整的前向传播,导致输出文本越长,响应时间越长,从而影响GPU利用率和用户体验。
目前的主流解决方案包括自回归草稿模型与并行草稿模型,但各自存在质量和效率上的不足,并且缺乏负载自适应校验机制。这促使DeepSeek开发出了DSpark推测解码框架,其采用半自回归架构,通过两套互补机制来平衡生成与校验的关系,旨在同时实现高吞吐量和自适应负载检测。
根据论文中的测试结果,DSpark框架在数学推理、代码生成和日常闲聊等三类任务的性能表现上,明显优于现有的自回归草稿模型和并行草稿模型,能在单个对话轮次中提升可接受词元长度。
DeepSeek已在其在线服务系统DeepSeek-V4中应用DSpark,评估显示该框架能在相同吞吐量下将用户生成文本的速度提升60%-85%。另外,DSpark还成功部署于阿里Qwen系列模型,进一步提升了生成效率。
技术上,这项研究通过算法创新显著提升了模型推理的生成速度。在大模型应用逐渐成熟的背景下,如何实现低成本、高效率的输出将是竞争的关键。同时,DeepSeek通过开源此框架,进一步推动了技术社区的发展。
不少开发者在社交平台上肯定了DeepSeek的努力,认为其在模型优化和推理基础设施上同步迭代,将有助于未来的长远发展。尽管面临商业化挑战,DeepSeek似乎仍将坚持其开源的初心。
文章来源:https://tech.sina.com.cn/roll/2026-06-27/doc-inievzuu3819972.shtml